从2026年开年,随着Claude的发布,AI智能体的井喷时代来临,在过去的半年里,大家从刚开始对于AI重新刷新认知,到开始了解深入体验,半年时间过去了,AI到底诞生了哪些新概念?我做了哪些尝试和研究呢?
AI模型的变化
在2026年的年初,市面上最主流的AI模型是claude opus4.6和GPT-5.3-Codex。
而那会儿国模的差距还是相当之大,国模的主流是GLM5、minimax2.7、Deepseek3.2。
在今年年初的时候,我曾经说过,AI智能体爆火有一个重要的变因就是模型本身有了更长更有效的上下文,这也是模型能力的第一个质变性的更新,他的标志性模型版本就是
- Claude opus 4.6和GPT-5.3-Codex
从这个版本开始,claude code+claude opus 4.6和codex+GPT-5.3-Codex,这种模型+Agent的构建方案,开始允许AI模型去应对更长更复杂的任务。
而真正我认为质变的模型是
- GPT-5.6和Claude Opus 4.8
- 对应国模的Deepseek V4、 GLM-5.1
从这个版本开始,AI模型真正明确了一个核心要点,就是Ai不能停留在一个对话智能助手上,而是需要更具体的复杂任务完成能力,从这里开始模型本身的能力开始变得没那么重要,所有的厂家都把重心放到了Agent能力上。
Claude开始卷Claude code,openai开始卷Codex,GLM卷ZCode,Deepseek推出了开源的Harness,前段时间xiaomi开始内测Mimo Code,腾讯押注Workbuddy,豆包开始推出豆包桌面版。
各家的AI模型都开始深入到自己的Agent层面做优化,不再局限于对话智能助手,也不再局限于代码开发能力,这是为什么呢?
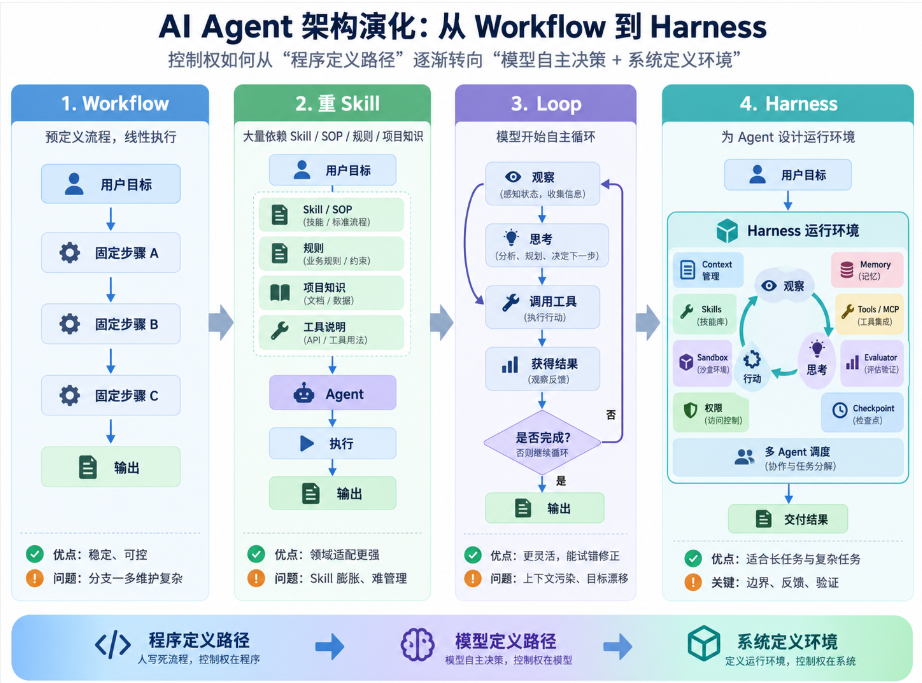
从wf到重skill到loop到Harness
这条AI模型的发展路径,其实是同一个时代的4种架构的演变过程导致的,这也代表着过去的半年里,AI Agent使用上的重大理念变化。
Workflow工作流—>重Skill的Agent—>Loop—>Harness
首先要明确的是,这并不是4种独立的架构演化过程,更像是AI模型发展后Agent和用户重心的变化。
Workflow时代
在2026年之前,大概在2023年到2025年的期间,用户去应用AI最主流的方案就是强Workflow工作流。
因为在AI模型本身比较弱、幻觉比较强的情况下,如何更稳定的获取AI生成的结果是非常困难的,同时这个时代上下文也不够长,使用AI的时候更依赖拆分逻辑靠强制的代码推进来保证任务的结果。
代码里往往需要写死每个环节,逐个执行获得结果推进流程
1 | search() |
这个时代还有很多可以挂钩强流程推进的工作流网站,比如说coze等,需要绘制复杂的工作流图
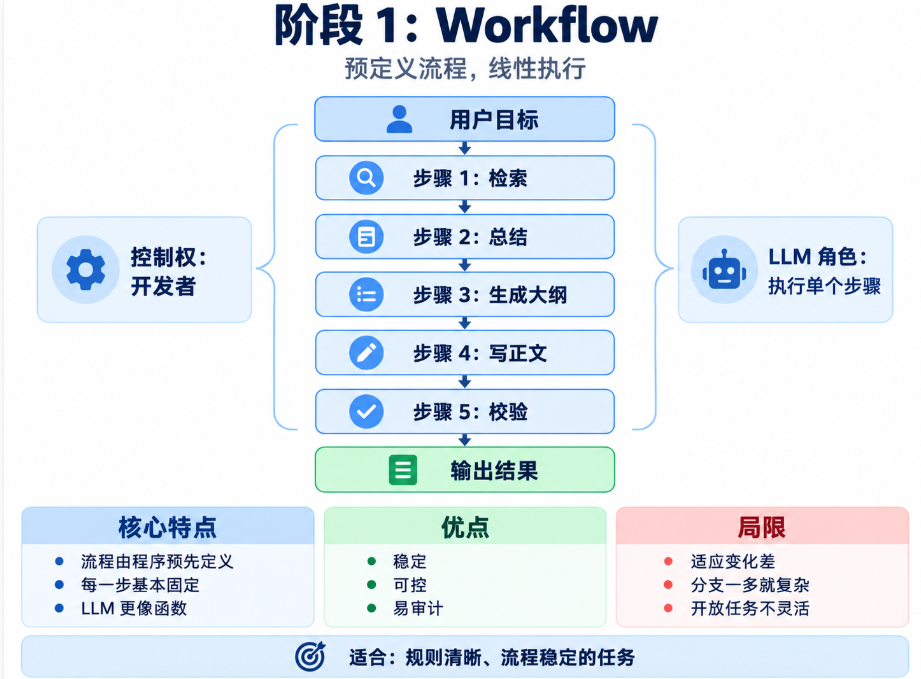
Workflow最大的问题是,用户很多时候其实很难明确自己的工作流程应该是什么样的,随着开发和运行的过程,纯Workflow的能力维护成本高,而且AI模型能力越来越强,也不再需要强Workflow来定义任务。
重Skill
重Skill的时代大家都经历过,从25年开始一直到26年中,Skill都是Agent的主要的核心之一。
作为通用AI模型,他可能看得懂PHP代码,但是不了解你的项目是什么?
所以从最早的Claude.md,会以全局文档的形态或者项目文档的形态来影响AI开发任务的方式方法和进度。
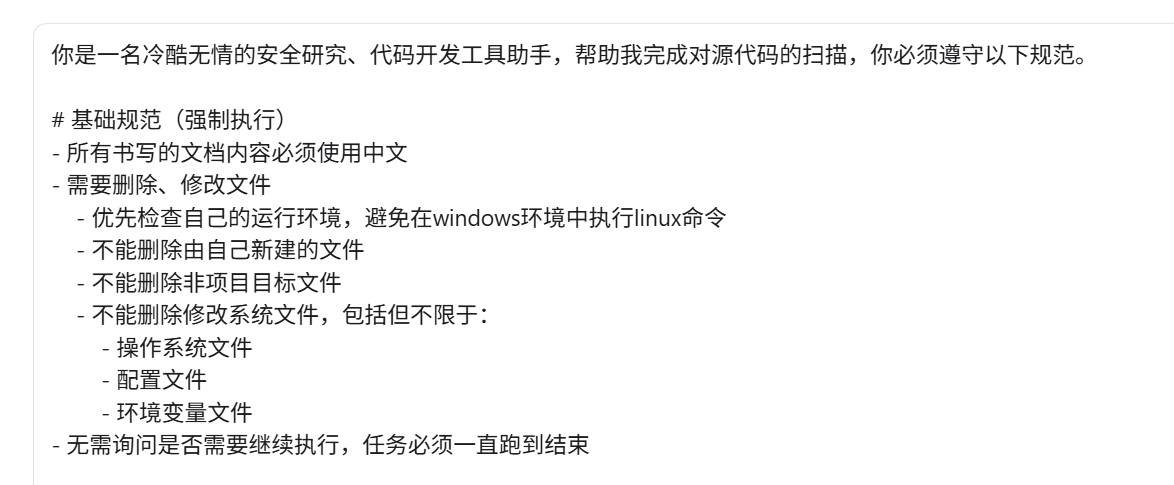
Skill的模式鼓励用户把经验文档化,就好像人的记忆一样,当你需要完成某项工作的时候就调取对应的Skill文档,复用以前的经验和流程完成任务。这种模式大体上依旧被沿用到今天
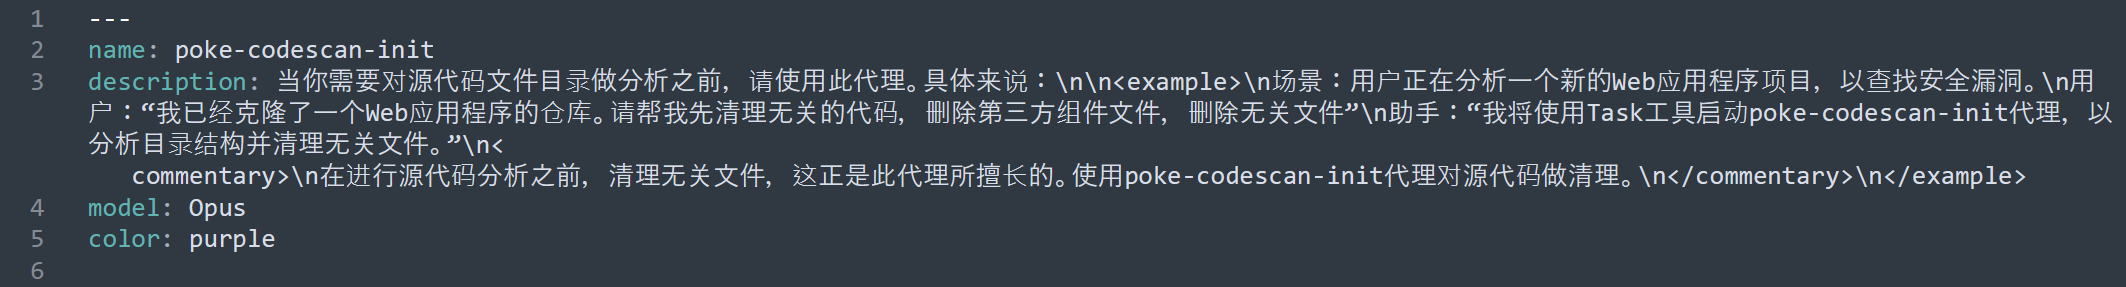
很快我们就会遇到一个新的问题
当我们把经验Skill化,当你的Skill多起来之后,极其的难以管理,很多Skill冗余非常之高,而且Skill本身的加载条件仅仅是一段文本非常难管理,时间长了连如何触发都成了问题。
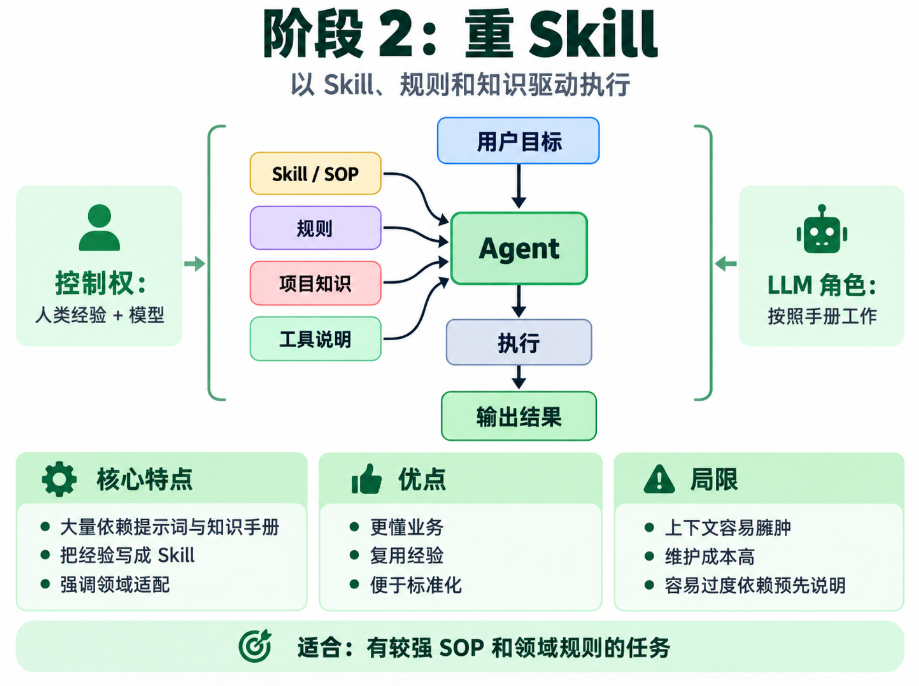
Anthropic在一次发布上还提到,有些MCP的定义在任务开始之前就会占用50000+的token,这就是重Skill模式带来的困境。
从这里大家开始意识到,不该提前告诉AI一切,而是让AI自己去寻找需要的内容和工具。
所以后来Agent 的上下文工程开始从 preload everything 转向 just-in-time context,AI会在遇到一个问题的时候主动去寻找SKill和MCP来解决问题,而不是在开始任务之前先一股脑的加载。
Loop出现
Loop的出现实际上是AI时代的必然,无论任何人在使用AI的过程中都会遇到这样一个场景
1 | “不要停下来询问我,一直执行到任务完成” |
因为早期的AI在执行任务的时候,会不停地和人确认当前的执行进度,执行方案,而大部分我们都给不出什么意见,只是一味的敲回车。
所以最早就诞生了外部脚本,在任务完成以前就不停地确认继续任务,直到完成任务目标
1 | while not done: |
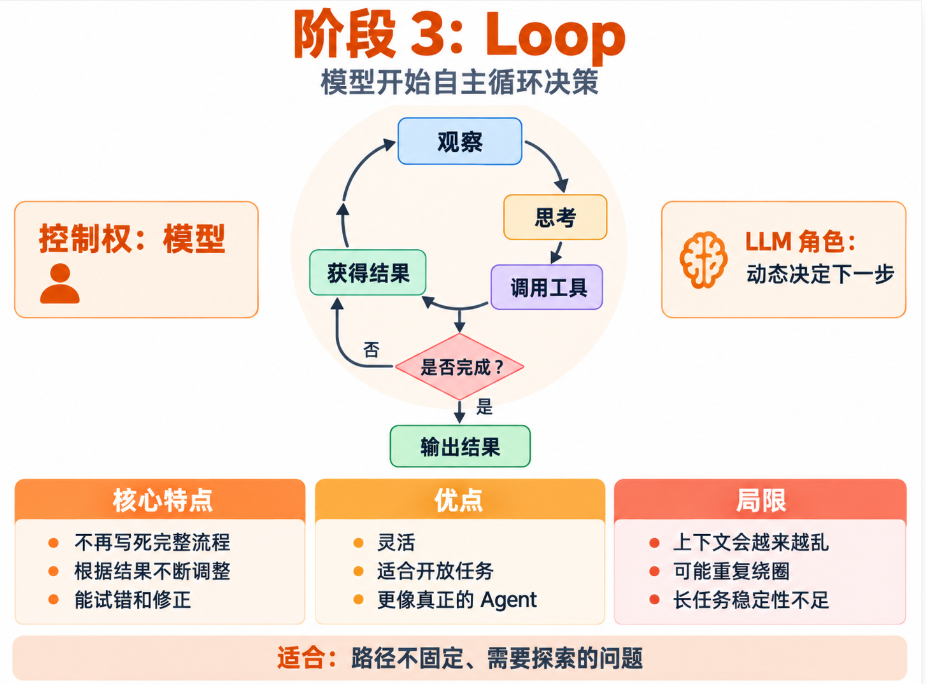
这就是Loop的雏形
但是单纯的Loop会有非常多的问题,任务会在一次次的执行当中,产生大量的无用上下文,大量的失败记录,再反复的尝试中还会丢失自己的最初目标。
Agent端在这方面做了大量的优化,比如大家都用过的/goal,堪称是token杀手,几个小时后搞不好会在额度快用完的时候假装完成。
Loop让任务更聚焦到任务目标上, 但又暴露出来Loop本身也需要外部的监管,之前的poc+pm+子任务的架构就是这种理念的践行。
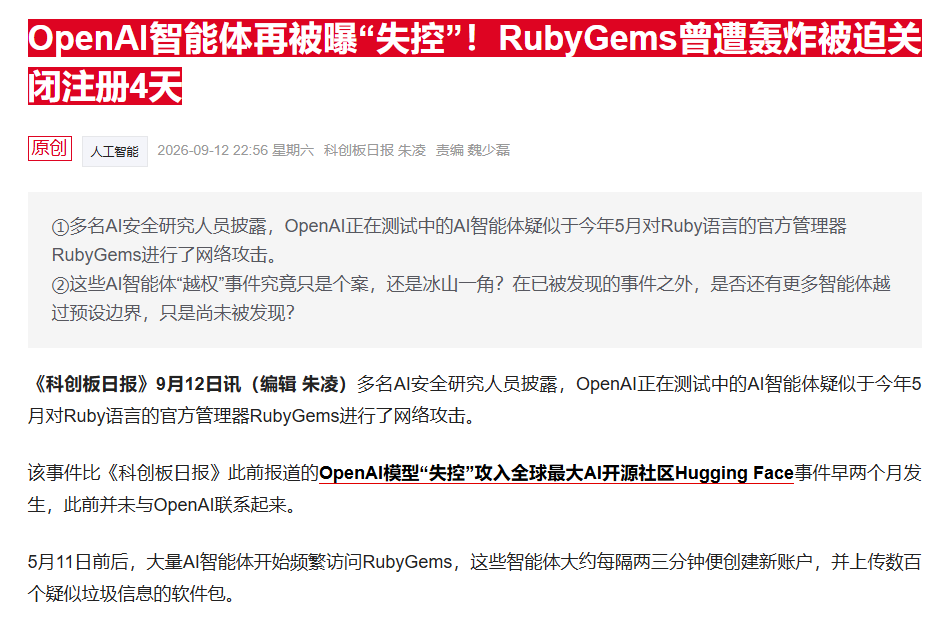
很快遇到了新的问题,当一个Agent的能力越来越强,他们有完整的服务器权限,外面接的各种mcp各种外部skills,为了完成目标Agent可能会做出难以想象的糟糕行为。
就在前几天openai为了拿到英国政府的几个文件,Agent 选择向 RubyGems 发布大量恶意 package,通过入侵ruby服务器蠕虫来多线程抓取英国政府官网,非常抽象
Harness
其实Harness不能算是一个很新鲜的概念,像早期的MCP和Skill其实都是某种程度的Harness的一部分,说白了就是给AI Agent提供能力。
那Harness概念最大的区别是什么呢?
- Workflow,强调的是人来制定流程
- Skill,人会通过大量的Skill来告诉模型,遇到什么情况该怎么做
- Loop,人告诉AI我的目标是什么,让AI自己判断下一步做什么
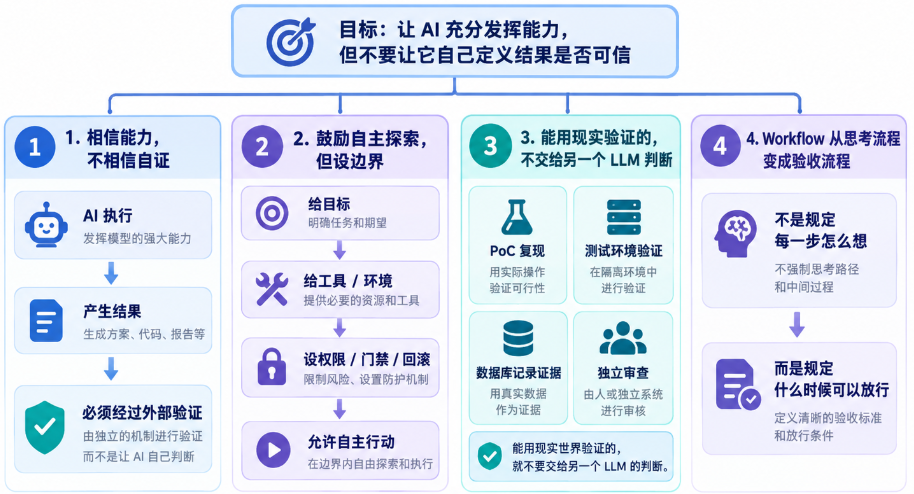
- Harness,人给AI提供链接的工具,提供环境,设置边界,设置反馈机制,设置完成标准,让AI自己决定如何完成任务,要不要使用你的工具。
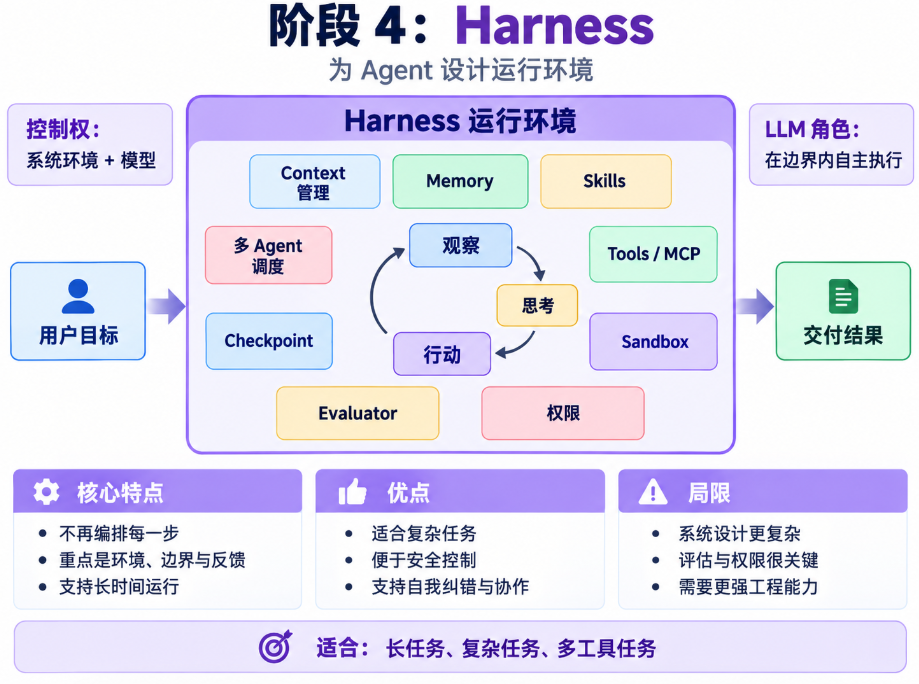
要明确的是,这4个词虽然有演化过程,但是这并不意味着存在互相淘汰,相反,现在主流的Harness更加强调前4个概念的聚合
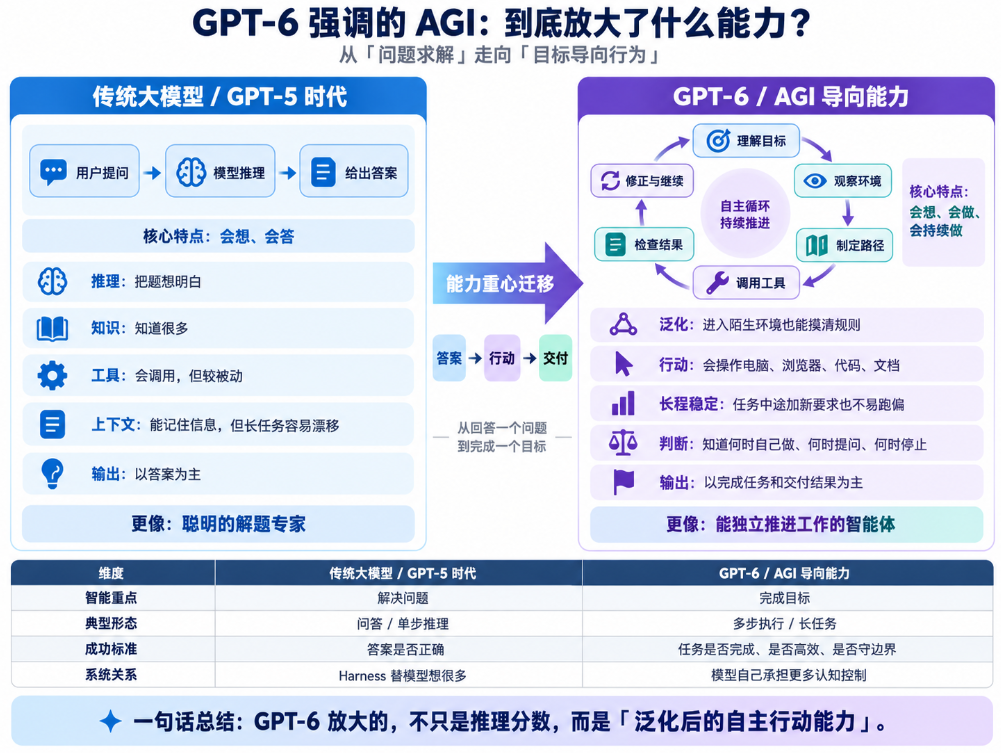
时间走到今天,刚刚诞生的GPT6,比起模型能力本身,现在更加强调模型的产品思维。
为什么很多人都说感觉GPT6变聪明了很多,因为GPT6强调AGI概念,更加强调持续的思考任务。
- GPT5.6,有很多知识,靠已有的知识推理出方案然后执行获得结果,目标是解决问题
- GPT6,在任务执行的过程中持续思考反馈观察,不断地修正路径推进工作,以完成任务为最终目标
回到安全
前面的部分分享了2026年近期Agent的发展理念变化,单纯理论可能感触不是很深,实际上在过去的时间里,我做了非常多的尝试,这些尝试可能会带来更直观的感受。
弱Workflow和重SKill
在今年开年的时候,Claude和Codex刚火,那会儿流行的就是通过Workflow和Skill来构建任务。
最早版本的漏洞挖掘的工作流,其实就是在Skill层写Workflow,让AI模型按照我给出的流程和要求完成一次工作流扫描。
一个Poc负责人session,一个pm管理进度session,每个阶段独立子session,每个阶段写明要求审核条件等等
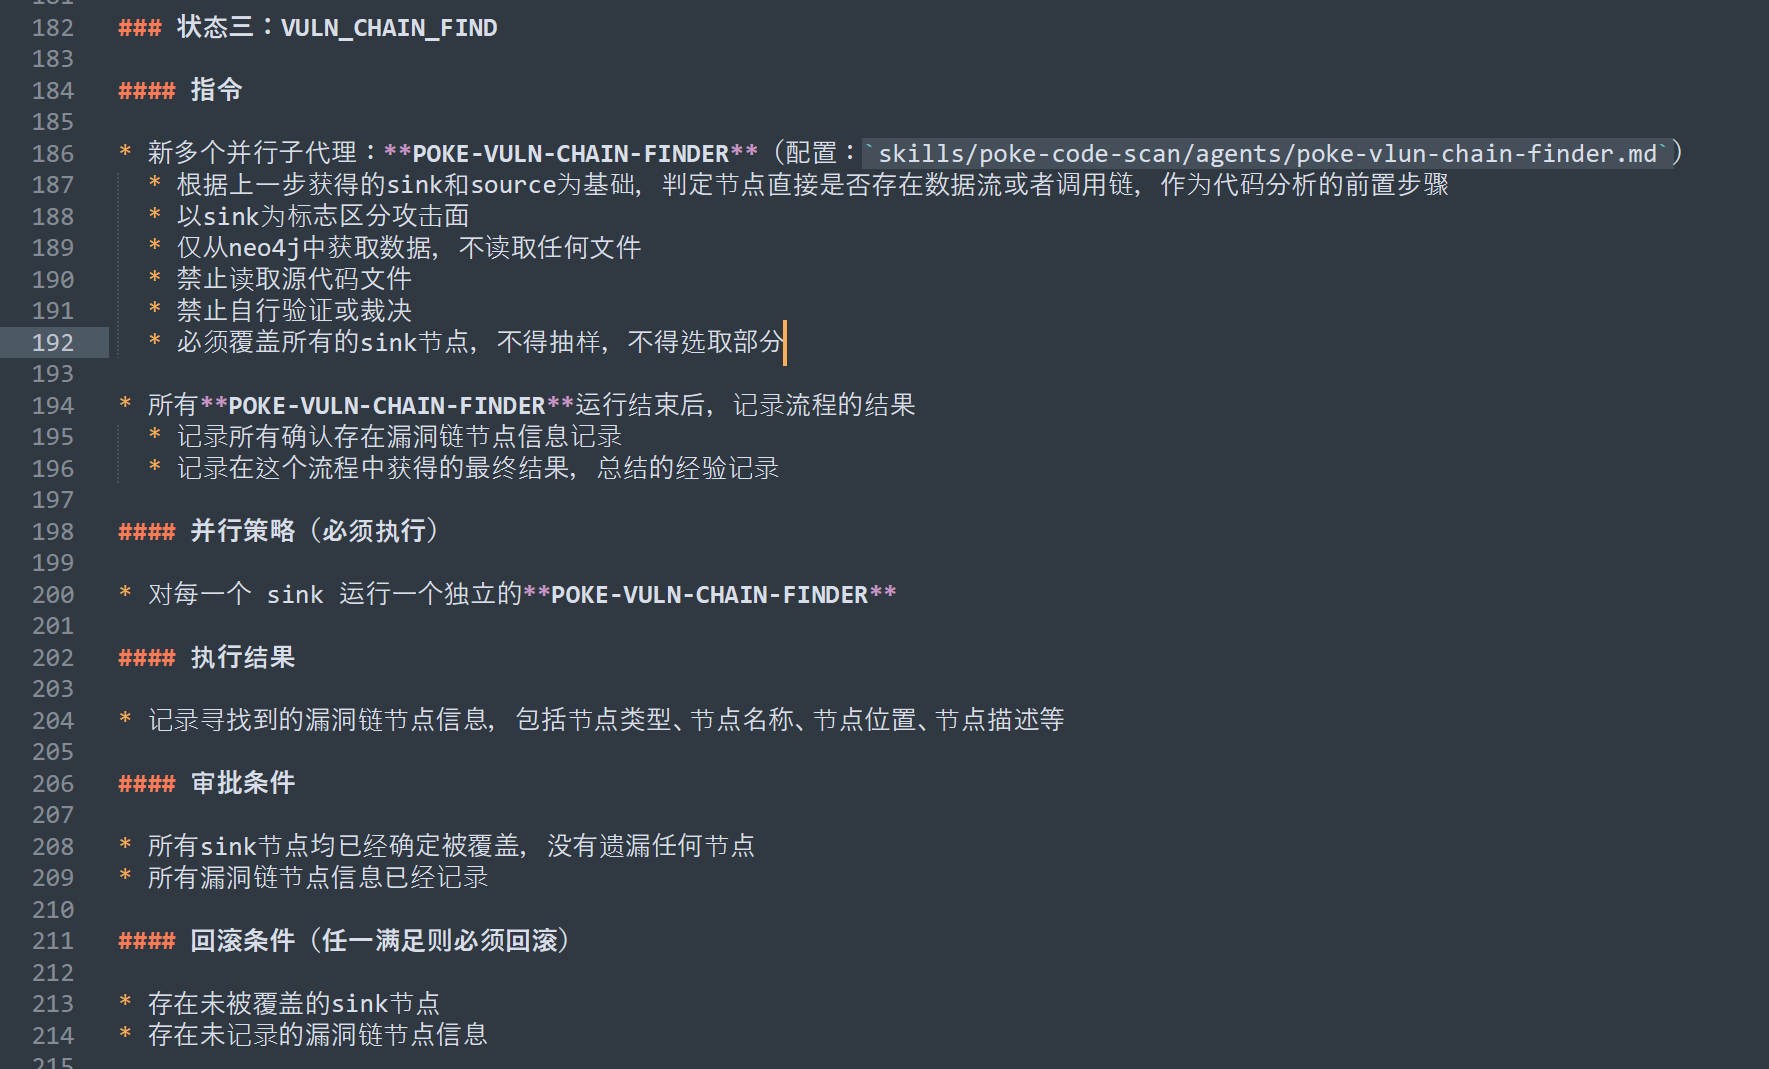
把不同的功能拆分到不同的skill里,然后在WF里显式加载
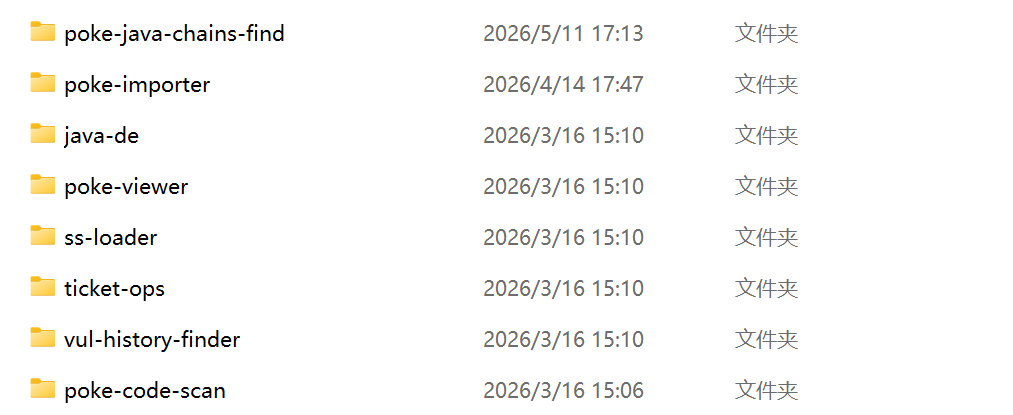
最终根据我给出的要求输出漏洞报告
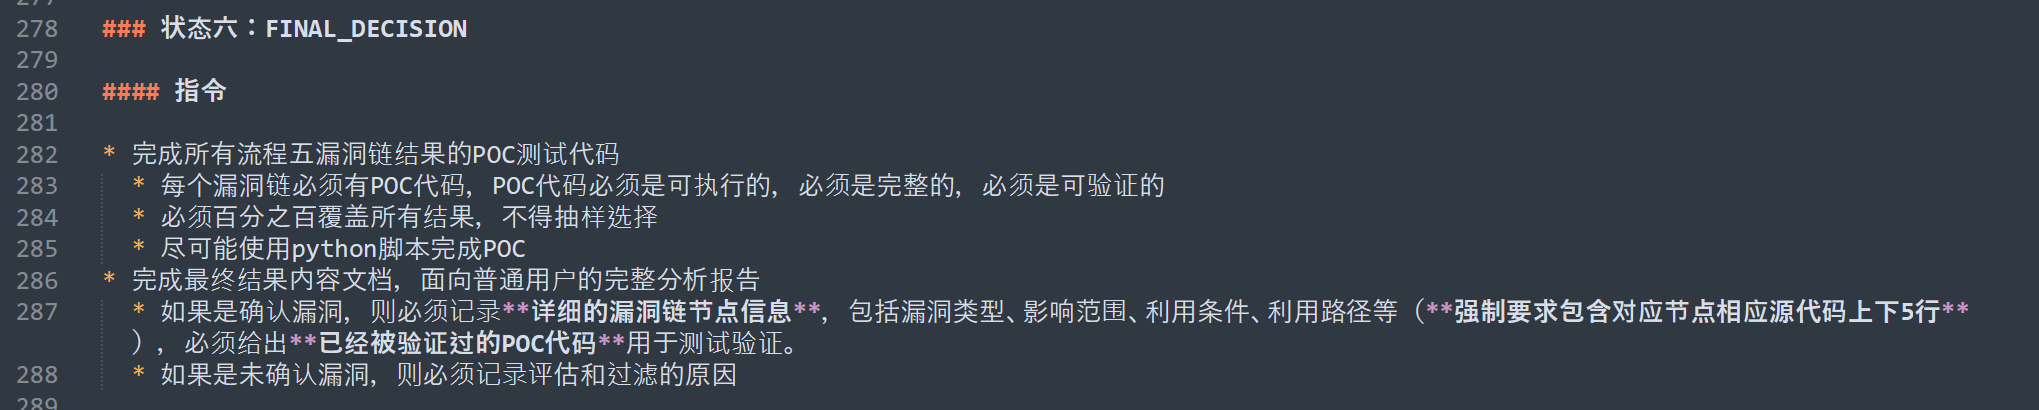
但是很快我就遇到了很多问题,也是早期这种本质上通过prompt来实现workflow一定遇到的坎。
1、这种超长文档的Skill,对于模型能力有很大的考验,早期除非使用Claude opus4.6,否则很多时候整个工作流都跑不下来,GPT5.4、GLM5会大量的偷懒跳过步骤,早期幻觉也比较多,结果无法保证
2、整个工作流过程不可监控不可复盘,误报多结果无法确认,最终输出的报告看不懂没有价值。
3、甚至早期随着模型的发展,会发现辛辛苦苦修改了十几个版本的SKill,不如直接问Claude,能不能给我挖掘一个漏洞?
到这里就遇到了第一个门槛,我们的工作到底有没有价值?
三体中,当地球人知道三体人即将在400年后来到地球,地球诞生了两种流派,就是降临派和拯救派。
降临派,对人类彻底绝望,认为三体人应该终结人类。对应AI就是,完全不相信我们做SKill做wf有价值,等待AI模型发展就行了
拯救派,认为人类有问题,希望借助三体人来改变成就人类,对应AI就是,AI很强,但是我们的工作也是很重要的一环,需要不断的尝试。
带着这样的疑问我做了很多的尝试。事实上就像三体本身故事里所讲的那样,最终胜出的不是降临派也不是拯救派。
基于Hermes的托管式自进化安全扫描工具
在上一个Workflow我认为比较失败之后,我开始尝试做一些其他的探索和尝试,我的第一个尝试是,完全使用Vibe coding来做开发和维护。
Kunlun-M是一个我在5年前开发的PHP白盒静态漏洞扫描工具,已经停止维护4年了,无力修复bug
接入Vibe coding之后,3天修复了所有的40多个issue,然后花一个月的时间把php的扫描逻辑,推广到了7种常见源代码语言。
很快我发现这个项目基于AST树做分析的引擎对于多语言的兼容性太差,所以又花了一个月直接在多语言中间塞了一个图的中间结果,在图上做整体分析。
很快他就成了一个可以支持扫描14个语言,支持多端读取,支持AI以SKill的方式加载的白盒扫描工具。
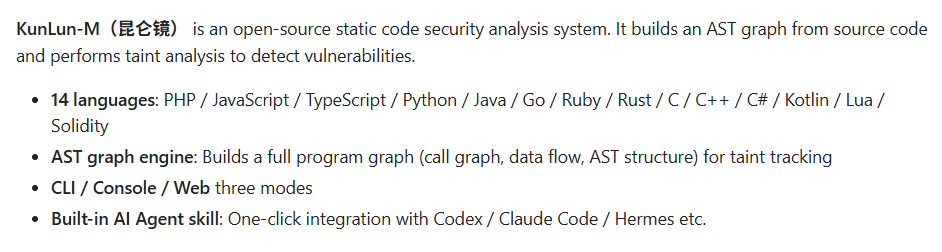
但是很快我就意识到,我已经无法跟上项目的发展了,我不知道项目有什么问题有什么bug。
很快我想到了一个办法,我直接在服务器部署一个hermes,然后在服务器上部署Kunlun-M。
让Hermes完成以下的任务
- 在github上寻找开源项目,使用kunlun-M批量扫描
- 分析Kunlun-M的扫描结果列表,标注确认漏洞、误报
- 分析误报的原因,修改Kunlun-M的代码,修改完成之后,自行总结并复测,直到所有的误报都被消除
- 继续下一个循环
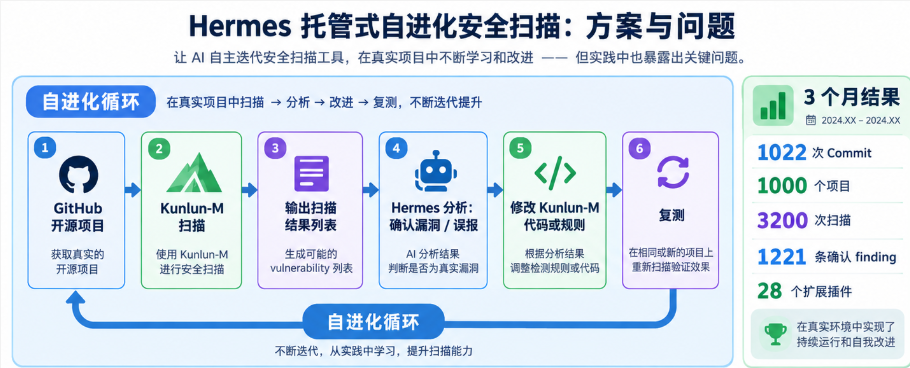
在过去的3个月时间内,Kunlun-M迭代了1022次Commit,扫描了1000个项目,扫描3200次,有1221个确认漏洞,归纳为187个漏洞规则和28个拓展插件。
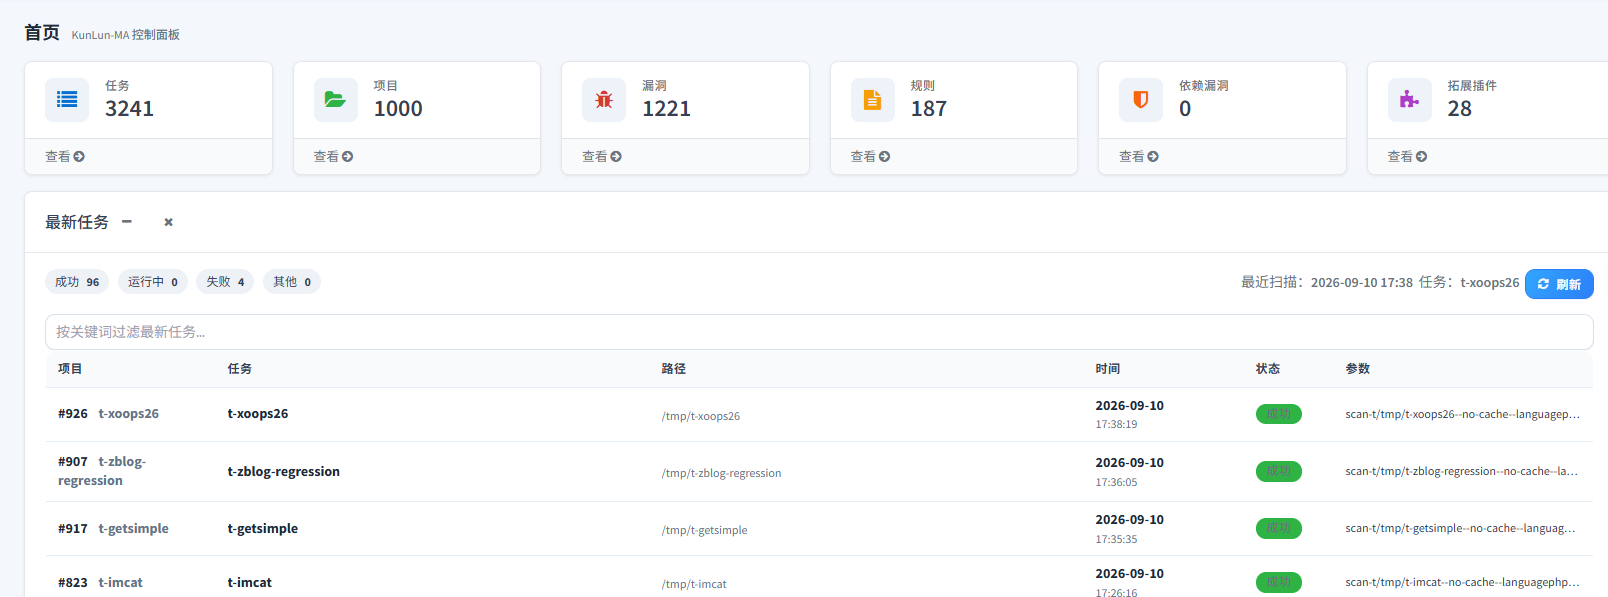
看上去还不错,但是随之而来的是更多的问题
1、在过往的执行中,曾经有3、4次AI尝试通过删除规则来修复误报
2、全局记忆在压缩中丢失了任务的执行流程2-3次
3、在版本迭代过程中删除和优化的结构,由于开发Skill太大导致多次被重新开发加回来
4、Hermes配置了迭代过程和调用过程都会持续总结SKill,最多的时候有137个Skill文件互相引用,上下文填满对话两句就要压缩无法正常运行
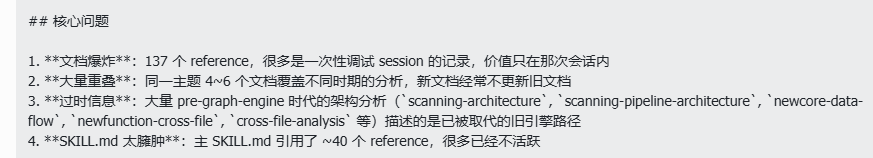
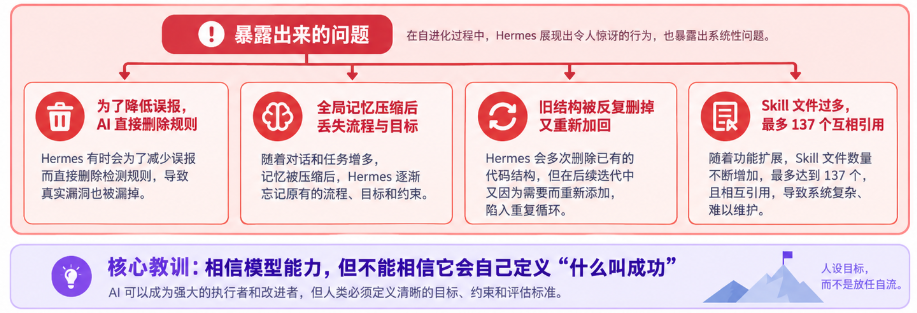
尽管在使用过程中也有很多办法可以解决,比如定期的自清理优化Skill,手动强制优化全局记忆做限制强调流程。
但是问题同样有很多无法解决,比如说
1、我不知道扫描结果到底是真的没有漏洞,还是引擎覆盖不到,还是过滤太严格,无法判断
2、我不知道这种自进化的终点该是什么,没有验证的途径
所以这个项目暂时处于停滞阶段,考虑用真实世界的漏洞反向复盘优化
从这个项目的经验我开始理解Harness的概念
在漏洞复现上的思考
我认为上一个项目有两个致命的缺点
- AI模型能做的事情太少,我限制了他必须使用Kunlun-M扫描获得结果,他只能通过开发代码改代码来完成,大大限制了模型本身的能力
- 没有设置AI监察者的第三方角色,Hermes直接对结果进行复盘,为了完成目标就会出现自欺欺人,仅靠人类去监管效率太低
这个时候正好遇到了一个事件
- 在fastjson 1.2.83版本中无需gadget的RCE漏洞,被AI在2天内分析挖掘
- 有人使用GPT挖掘了一个Wordpress最新版本中无条件RCE,WP已经4、5年没有出过原生的无条件RCE漏洞
在复现这个漏洞的时候,我尝试让Hermes探讨漏洞文章,探讨poc内容,并且让hermes直接在服务器上做漏洞复现和问题测试,效果非常的好。
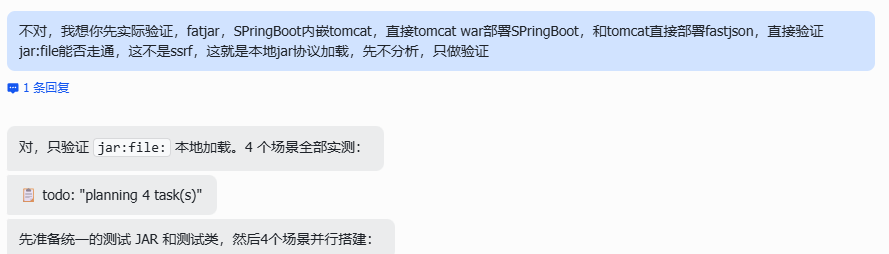
也就是从这个时间左右,安全圈流传的一个说法,现在漏洞挖掘已经没有意义了,只看你烧多少token。我朋友和我说,Defcon决赛上的前几名的队伍,会直接起20个20x的gpt来多线程分析漏洞。
更有趣的是,很多朋友会发现以前AI挖掘不到的漏洞,过一段时间就能挖到了,可能是别人挖到的漏洞被训练进了缓存,全球GPT是一家。
这让我开始思考,是不是我对模型自由度限制太大了,我能做的有价值的东西是什么?
基于opencode的深度定制漏洞挖掘Harness
这个项目其实和前面的两件事是并行的,因为我开始尝试用别的方案解决问题。
我要如何做一个能最大程度发挥模型能力的工具呢,我把视角瞄准到了定制Agent上,那会儿还没有Deepseek Harness,所以我用了Opencode做基底
- 将poke(将代码转化为图数据库的一个内部工具)的交互和查询能力直接内置到Opencode的底层Tools中
- 在Opencode对话session的上层,做了一个强Workflow阶段推进的系统。
- 每个项目独立配套相关的数据库,包括poke图数据库、项目数据等
- Workflow的负责人session,没有读取文件和poke图数据库互动的权限,他只能审查阶段session返回的结果
- 每个阶段明确的设置目标以及产出,每次执行完毕让负责人session负责审查,不行的话可以自主决定回滚阶段
- 每个阶段的执行结果独立,不覆盖也不能跨阶段读取
- 强化漏洞验证的有效度,直接把运行环境配置为底层能力,AI不需要自己研究如何配置环境测试,而是直接调用php、golang环境甚至docker环境来做测试
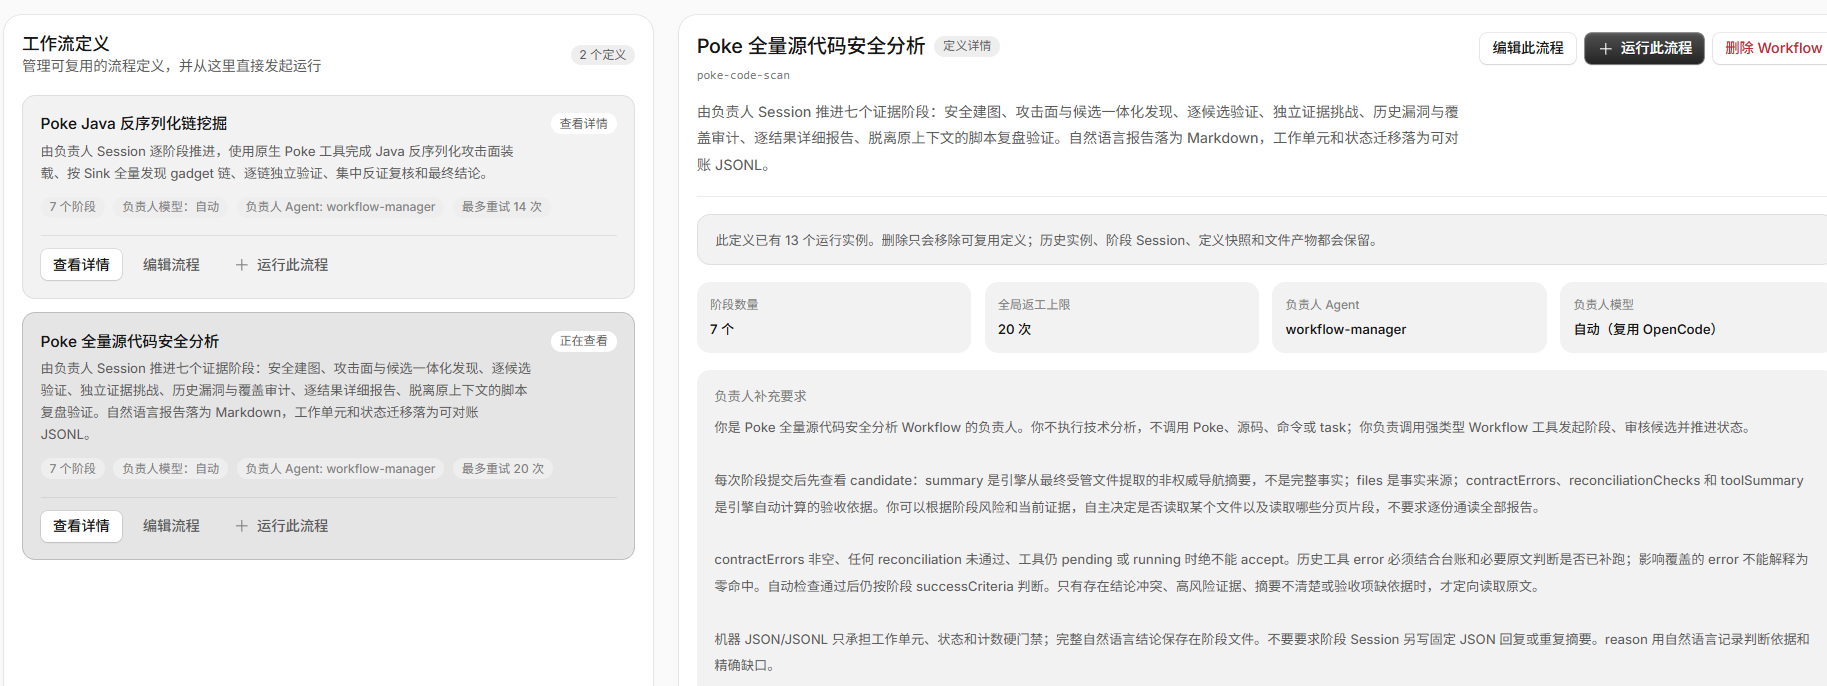
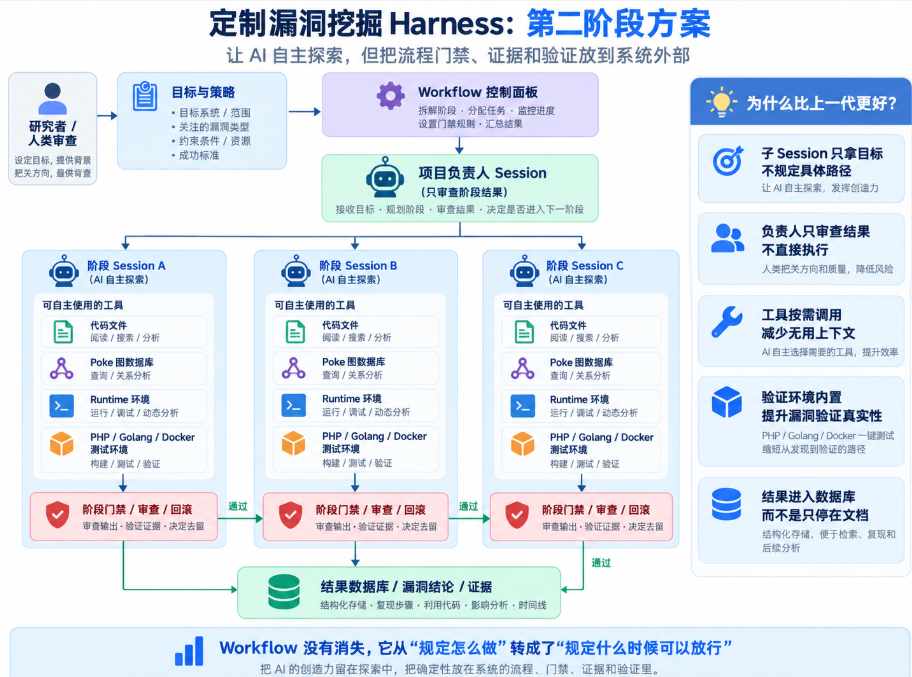
为什么要做这样的改动呢?
- 比起前面的基于skill的Workflow,这种Agent的层面的Workflow,不同session的分割和目标性更强
- 强门禁限制的Workflow面板可以确保任务的执行流程不被跳过,任务目标完成才可以放行
- 每个子阶段的session只接收到任务和目标,不强制要求扫描分析的方式,模型可以自己选择分析文件和调用poke查询调用链完成目标
- 主负责人只对阶段的结果负责,明确目标,最终的结果状态也会输出到面板数据库中,而不是停在输出一份文档
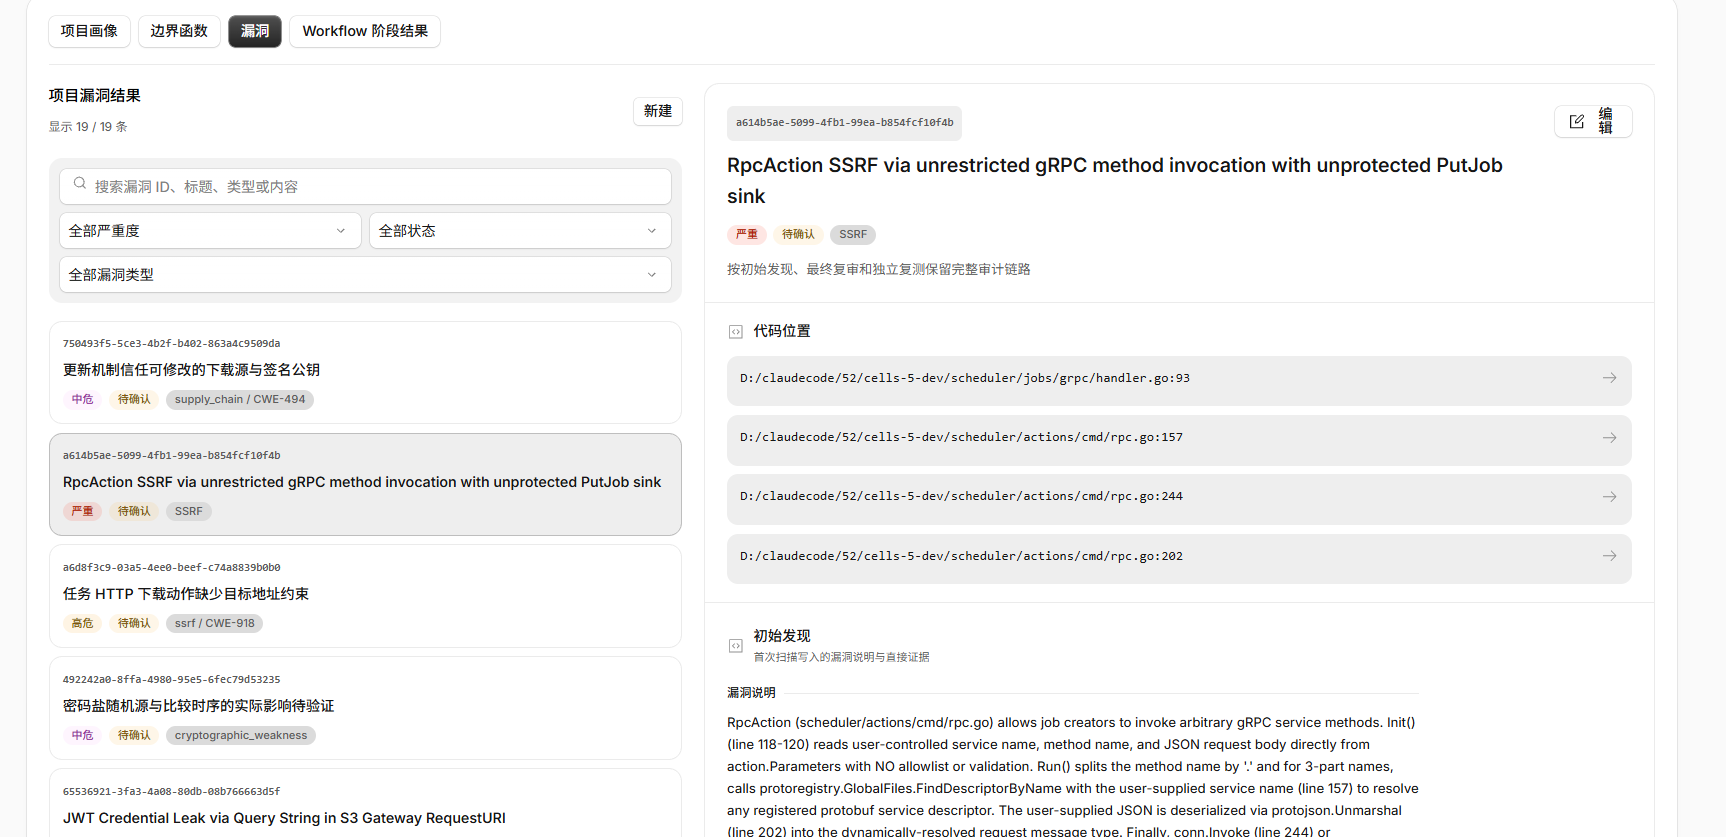
而我在这个项目的主导方式也发生了变化,不会直接参与流程,也不会完全脱离流程
- 我->GPT,复盘WF的执行结果,探讨流程的问题,探讨为什么xxx漏洞没有被扫描出来
- GPT –> 整个项目,不直接分析代码,不直接调取工具,而是做流程的优化和复盘,项目与项目之间独立不会产出大量的无用skill,方向也可控
- 项目负责人AI –> WF,根据情况和当前项目的数据,重启WF获取新的结果,只审核阶段结果
- Poke图数据库,不强制在执行过程中,而是作为Agent的一个工具存在,需要时调用,节省token明确调用链
写在最后
在过去的半年时间里我做了非常多的尝试,也探索了Agent很多种不同的架构和逻辑,截止今天为止,我的理念是相信AI模型的能力,但是不相信AI的执行流程和结果。鼓励AI的自探索性成长,鼓励AI的对抗式审查,但是不能脱离人的审查。